Für das Training setzen die meisten chinesischen KI-Anbieter noch auf Nvidia und für die Inferenz dann auf Huawei-Hardware. Der Atlas 960E SuperPoD mit Near-Packaged Optics soll nun auch das Training von Modellen mit 10 Billionen Parametern ermöglichen.
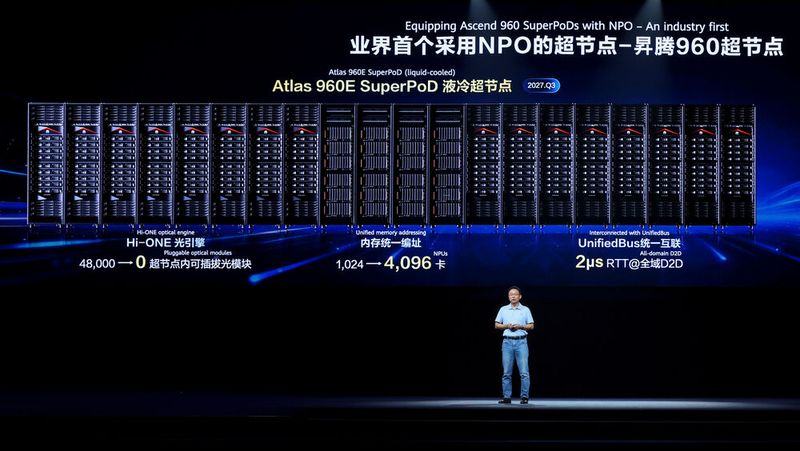
David Wang, Deputy Chairman of the Board und zum Zeitpunkt der Huawei-Connect-Konferenz noch Rotating Chairman von Huawei, präsentierte den Atlas 960E SuperPoD. Ein einzelner SuperPoD kann bis zu 4.096 NPUs umfassen, die über Near-Packaged Optics (NPO) verbunden sind.
(Bild: Huawei)
Huawei hat eine neue Generation von KI-Hardware und Computing-Architekturen vorgestellt. Im Mittelpunkt steht die Ascend-960-Serie mit dem neuen Atlas 960E SuperPoD, der als erstes SuperPoD auf Near-Packaged Optics (NPO) basiert. Damit will der chinesische Technologie-Riese leistungsstarke Alternativen zu Nvidia bieten.
Durch die KI-Welt läuft, zumindest bei der Hardware, ein immer tieferer Riss. Auf der einen Seite die USA sowie alle Länder, in denen die leistungsstärksten GPUs von Nvidia und, in kleinerem Ausmaß, auch AMD eingesetzt werden. Auf der anderen Seite China, das gezwungenermaßen im großen Stil eigene KI-Hardware verwendet. Denn bereits die Biden-Administration hat nur den Export von in der Leistung beschnittenen GPUs nach China erlaubt. Die Trump-Regierung hat diese Regeln beibehalten und teilweise sogar verschärft.
Da die immer größeren Modelle für das Training und auch die Inferenz entsprechend starke Hardware erfordern, hat dass Embargo chinesische Herstellern, allen voran Huawei, die Möglichkeit eröffnet, auch mit nicht ganz so schnellen KI-Chips den lokalen Markt aufzurollen – sie mussten nur annähernd so schnell sein wie die beschnittenen Nvidia-Karten und zudem günstiger. Dazu kam, dass die chinesische Regierung den Providern den Einsatz eines gewissen Anteils von im eigenen Land produzierter Hardware vorschreibt.
Huawei Ascend-960-Serie
Platzhirsch in China ist Huawei mit den NPUs der Ascend-Serie. Auf der Huawei-Connect-Konferenz Mitte September hat der Hersteller verkündet, den Launch des Ascend 960DT mit bis zu 288 GB HiZQ-Speicher, Huaweis eigener Implementierung von HBM, auf das erste Quartal 2027 vorzuziehen. Im dritten Quartal soll dann, ebenfalls früher als ursprünglich geplant, die Verfügbarkeit des Ascend 960PR folgen. Er soll eine höhere Compute-Leistung liefern und damit beispielsweise beim Prefill eine höhere Leistung liefern. Dafür bietet er aber eine geringere Speicherbandbreite.
Insgesamt sollen die 960er-Modelle eine verdoppelte Rechenleistung gegenüber ihren Vorgängern der 950er-Generation liefern. Damit sind sie wohl immer noch langsamer als Nvidias Blackwell-GPUs, von Rubin ganz zu schweigen. Das liegt primär daran, dass Huawei wegen der US-Embargos keinen Zugriff auf moderne EUV-Fertigungsverfahren hat, die für eine höhere Performance notwendig wären. Der Trick, durch „Logicfolding“ Signallaufzeiten zu verkürzen statt schnellere Transistoren zu nutzen, wird bei den Ascend-960-Bausteinen wohl noch nicht genutzt. Huawei bezeichnet die Leistungssteigerung durch das Verkürzen von Signallaufzeiten übrigens als „Tau-Skalierungsgesetz“. Das soll wohl erst bei der Ascend-NPUs der Serien 970 und 980 zum Einsatz kommen, die David Wang, Deputy Chairman of the Board und zum Zeitpunkt der Huawei Connect noch Rotating Chairman, bei einer Keynote ebenfalls erwähnt hat. „Dank des Tau-Skalierungsgesetzes werden sich nicht nur ihre Rechenspezifikationen weiterhin verdoppeln, sondern sie können auch enorme Verbesserungen in Bezug auf Speicherbandbreite, Speicherkapazität, Interconnect-Bandbreite und mehr erwarten“, so Wang.
Um das Problem der noch fehlenden Chip-Performance zu umgehen, setzt Huawei mehr Chips pro Cluster ein. So soll dennoch eine hohe Gesamtleistung ermöglicht werden. Bisher wurden die Huawei-Cluster von den chinesischen KI-Firmen trotzdem primär für KI-Inferenz genutzt, während das Training auf den immer noch schnelleren Nvidia-Clustern läuft. Das soll sich nun mit dem auf den neuen Ascend-960-NPUs basierenden Atlas 960E SuperPoD ändern. Er ermöglicht mit maximal 4.096 Ascend-NPUs, einem Petabyte HBM und bis zu 16 EFLOPS FP4 Huawei zufolge die Inferenz und das Training von sehr großen KI-Modellen. Um das zu erreichen, wendet der Hersteller das Tau-Skalierungsgesetz an, allerdings auf der Ebene eines Clusters statt auf der eines Chips. Die NPUs in einem Atlas 960E SuperPoD sind durch optische Hochgeschwindigkeits-Interconnects verbunden, was den Datentransfer zwischen den Nodes im Cluster beschleunigt. Dabei setzt Huawei nicht auf die bisher genutzten optischen 800G-Transceiver-Module, sondern auf Near-Packaged Optics (NPO) mit der für Atlas 960E entwickelten High-density Optical-interconnect-Node Engine (Hi-ONE).
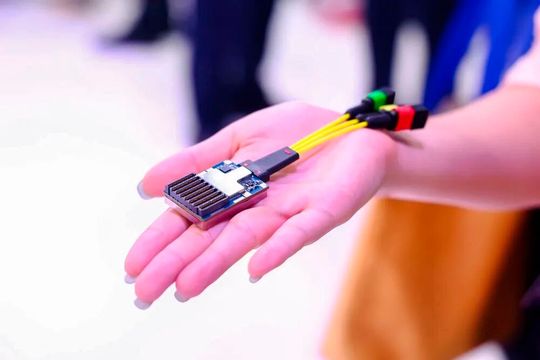
NPO-Module von Huawei erreichen Übertragungskapazität von 7,2 Tbit/s.
(Bild: Huawei)
Bei NPO wird die optische Übertragungseinheit als Modul auf dem Mainboard eines Switches in der Nähe des ASICs platziert. Laut Huawei erreicht Hi-ONE als erste NPO-Implementierung in einem Serienprodukt eine Übertragungskapazität von 7,2 Tbit/s pro Engine bei einer um den Faktor 10 reduzierten Latenz. Statt der ansonsten erforderlichen 48.000 optischen 800G-Module sollen so 5.500 Hi-ONE-Einheiten für die Verbindung der 4.096 NPUs ausreichen, was zudem den Energieverbrauch des Systems um mehr als 550 Kilowatt senkt.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel IT-Medien GmbH, Max-Josef-Metzger-Straße 21, 86157 Augsburg, einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von Newslettern und Werbung nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung.
Peerium für Super-Cluster
Für extrem große Modelle mit 10 Billionen Parametern reicht laut Huawei ein SuperPod nicht mehr aus. Stattdessen werden mehrere KI-SuperPoDs, General-Purpose-SuperPoDs und mehrstufige Speichersysteme durch einen UnifiedBus (UB) miteinander verbunden. Die Technologie dahinter bezeichnet der Hersteller als Peerium Computing Architecture. Dafür werden verschachtelte Parallelisierung (Nested Parallelism), eine einheitliche Speicheradressierung und Peer-to-Peer-Interconnects kombiniert, um so bis zu einer Million Nodes als ein Computersystem zu betreiben. Ein Atlas 950 SuperCluster mit 256.000 Karten befindet sich bereits im kommerziellen Aufbau. Ein noch größerer SuperCluster mit Atlas 960E SuperPoDs ist in Planung. Er soll zunächst 512.000 NPUs umfassen und lässt sich per Multi-Rail-Topologie auf bis zu einer Million NPUs skalieren.
Der ebenfalls auf UnifiedBus basierende TaiShan 950 SuperPoD mit bis zu bis zu 4.096 Nodes soll agentische KI-Anwendungen deutlich schneller ausführen als herkömmliche Server. Als passendes Storage-System soll der OceanStor M900 Context Memory Storage mit einem sehr großem KV-Cache von bis zu 64 PB dienen. Huawei hat dafür eine Methode entwickelt, bei der die NPU direkt auf SSDs zugreifen kann, was die Zugriffszeit um 90 Prozent reduziert.
Wachsendes Software-Ökosystem
Ein wichtiger Punkt, der Nvidia zum führenden Anbieter von KI-Hardware gemacht hat, ist dessen umfangreiches Software-Ökosystem mit Cuda im Mittelpunkt. Huawei öffnet daher Teile seiner Software. Die Grundlage des Ascend-Ökosystems nennt sich CANN (Compute Architecture for Neural Networks) und wird inzwischen als Open-Source-Entwicklung vorangetrieben. Dem Hersteller zufolge werden mittlerweile mehr als 40 Modelle nativ auf Ascend und CANN vortrainiert. Deepseek gibt das gemeinsam mit Huawei entwickelte TileLang-Toolkit für Huaweis-Ascend-NPUs als Open Source frei. TileLang-Ascend ist eine High-Level-Programmiersprache, die das Entwickeln von KI-Anwendungen einfacher machen soll als Nvidias Cuda, dabei aber trotzdem Möglichkeiten zur Optimierung auf die Hardware bietet.